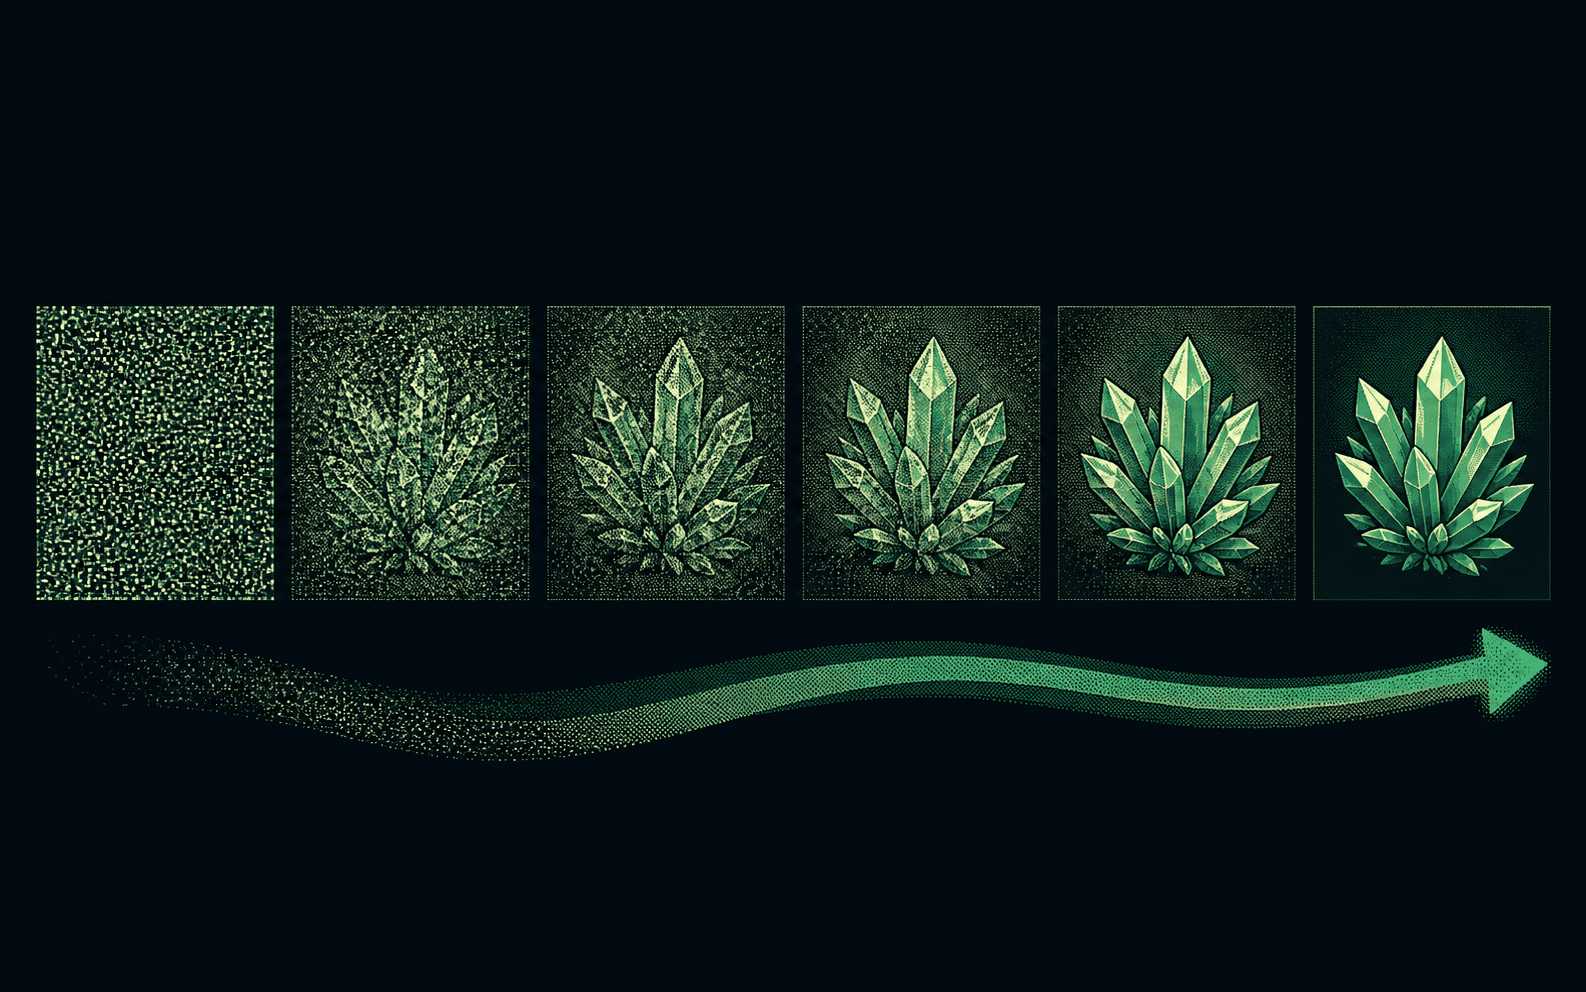
Un modèle de diffusion apprend à retirer progressivement du bruit. Pour générer une image, le processus part d'un bruit pseudo-aléatoire, le débruite en plusieurs étapes, puis transforme la représentation obtenue en pixels.
Du bruit vers une structure
Pendant l'entraînement, le système ajoute du bruit à des images et apprend à prédire ce bruit. Pendant la génération, il part dans l'autre sens. Il ne révèle pas une image cachée sous le bruit : il construit une solution possible à partir des régularités apprises.
Le rôle du texte
Le prompt est encodé dans une représentation numérique. Cette représentation guide le débruitage afin que les formes, relations et styles se rapprochent de la demande. Le guidage n'est pas une commande géométrique exacte. C'est une influence sur les choix possibles.
Pourquoi travailler dans un espace latent
De nombreux modèles ne calculent pas directement chaque pixel pendant toutes les étapes. Un VAE compresse l'image dans un espace latent plus petit. Le modèle diffuse dans cet espace, puis le décode en pixels.
Cette compression réduit le coût, mais elle peut perdre des détails fins. Le décodeur influence aussi les couleurs, les textures et certains artefacts.
Ce que le modèle contrôle mal
La diffusion excelle à produire une image globalement cohérente, mais certains détails imposent des relations exactes : texte lisible, nombre précis d'objets, mains complexes ou géométrie répétitive. Des modèles plus récents réduisent ces défauts sans les supprimer.
Les outils de contrôle ajoutent des contraintes : pose, profondeur, contours, image de référence ou masque local. Ils ne remplacent pas le modèle. Ils orientent une partie de sa génération.
Coût local
La génération d'image utilise surtout le GPU et la VRAM. La résolution, le nombre d'étapes, le modèle et les modules de contrôle augmentent la charge. Le rendu peut rester possible avec peu de VRAM grâce à l'offloading, au prix d'une latence plus élevée.
Une lecture pratique
Quand une image ne correspond pas à la demande, identifiez la source probable : prompt ambigu, seed défavorable, guidage trop fort, nombre d'étapes inadéquat, modèle mal adapté ou outil de contrôle absent. La leçon suivante donne un vocabulaire pour ajuster ces leviers.
L’essentiel
- Un modèle de diffusion apprend à retirer du bruit, puis génère en partant d'un bruit aléatoire.
- Le prompt guide le débruitage ; il influence les choix sans imposer une géométrie exacte.
- Beaucoup de modèles travaillent dans un espace latent compressé par un VAE, puis décodent en pixels.
- Texte lisible, nombre exact d'objets et mains restent des points faibles fréquents.
- En local, la résolution, les étapes et les modules de contrôle font monter la VRAM.
Testez-vous
Répondez de tête ou par écrit, puis vérifiez. Se tester juste après la lecture aide à retenir.
Le débruitage révèle-t-il une image cachée dans le bruit ?
Voir la réponse
Non. Le modèle construit une solution possible à partir des régularités apprises, guidée par le prompt. Un autre bruit de départ donne une autre image.
À quoi sert le VAE dans une diffusion latente ?
Voir la réponse
Il compresse l'image dans un espace latent plus petit où se fait le débruitage, puis décode le résultat en pixels. Cela réduit fortement le coût de calcul.
Pourquoi ajouter un contrôle de pose ou de profondeur ?
Voir la réponse
Pour imposer des contraintes que le prompt exprime mal : une posture, une profondeur ou des contours précis. Le contrôle oriente la génération sans remplacer le modèle.
Sources et pour aller plus loin
- Denoising Diffusion Probabilistic Models : l'article qui a popularisé la diffusion pour l'image (Ho et al., 2020).
- High-Resolution Image Synthesis with Latent Diffusion Models : la diffusion dans un espace latent, base de Stable Diffusion (Rombach et al., 2021).
- Documentation Diffusers : pipelines, schedulers et exemples de code.