Un modèle ne reçoit pas directement une phrase comme nous la lisons. Le logiciel transforme d'abord l'entrée en une suite d'unités numériques. Cette transformation explique une grande partie des limites de longueur, des coûts de mémoire et des réponses parfois surprenantes.
Du texte aux nombres
Le tokenizer découpe le texte selon un vocabulaire appris. Il associe ensuite chaque fragment à un identifiant numérique. Le modèle transforme ces identifiants en vecteurs, puis calcule leurs relations.
La phrase « Je construis mon homelab » peut être découpée en cinq tokens avec un tokenizer et en sept avec un autre. Il n'existe pas un découpage universel. Chaque famille de modèles possède son vocabulaire et ses règles.
La fenêtre de contexte
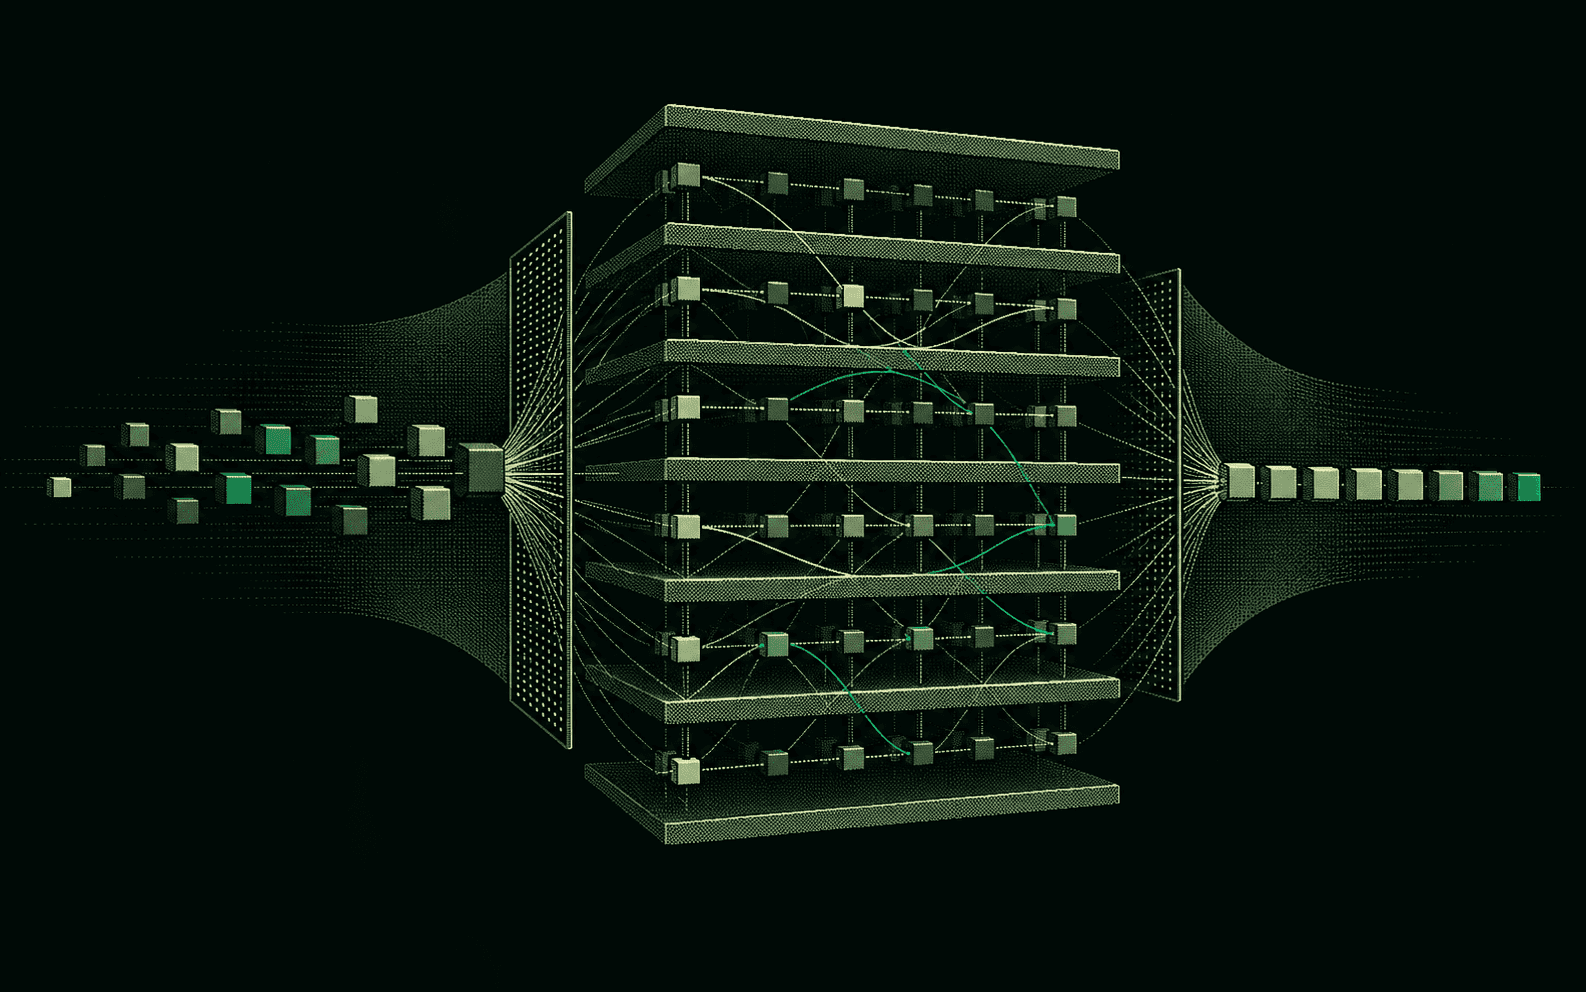
Le contexte est l'ensemble des tokens disponibles pour calculer la suite. Il contient votre demande, les messages précédents, les instructions du système et parfois des documents retrouvés par un outil.
Une fenêtre annoncée à 32 000 tokens fixe une limite de capacité, pas une garantie de qualité uniforme. Plus le contexte grandit, plus le modèle doit retrouver l'information utile au milieu d'éléments concurrents. Le KV cache occupe aussi davantage de mémoire pendant la génération.
Les données pendant l'entraînement
Pendant l'entraînement, les données servent à ajuster les paramètres. Leur qualité, leur diversité et leur préparation influencent les capacités apprises. Les doublons, erreurs et déséquilibres peuvent se retrouver dans le comportement final.
Il faut distinguer trois ensembles :
- Les données d'entraînement servent à ajuster les poids.
- Les données de validation aident à régler le processus sans apprendre directement chaque exemple.
- Les données de test mesurent le comportement sur des cas tenus à l'écart.
Si les mêmes exemples apparaissent partout, le résultat donne une impression trompeuse de performance. Le modèle peut avoir mémorisé des réponses au lieu de généraliser.
Les données pendant l'inférence
À l'inférence, vos données ne servent pas automatiquement à réentraîner le modèle. Elles deviennent des tokens dans le contexte. Un service distant peut toutefois conserver des journaux selon sa politique. Un service local peut aussi envoyer de la télémétrie si une extension ou une interface le prévoit.
Réduire un contexte trop chargé
Commencez par supprimer les éléments qui n'aident pas la tâche. Résumez l'historique ancien, récupérez seulement les passages utiles et séparez les demandes complexes en étapes vérifiables. Un contexte plus court et mieux ciblé est souvent plus efficace qu'une accumulation de documents.
L’essentiel
- Le modèle ne lit pas des mots mais des tokens, découpés par un tokenizer propre à chaque famille de modèles.
- Le contexte est l'espace de travail de la requête : instructions, historique, documents et question.
- Une grande fenêtre de contexte est une capacité maximale, pas une garantie de qualité sur toute sa longueur.
- Les données d'entraînement construisent les poids ; vos données d'inférence ne deviennent que des tokens du contexte.
- Exécuter en local ne suffit pas à garantir la confidentialité : vérifiez chaque brique.
Testez-vous
Répondez de tête ou par écrit, puis vérifiez. Se tester juste après la lecture aide à retenir.
Un token correspond-il toujours à un mot ?
Voir la réponse
Non. Selon le tokenizer, un token peut être un mot court, une partie de mot, un signe de ponctuation ou un fragment de code.
Après une conversation, le modèle a-t-il appris ce que vous lui avez dit ?
Voir la réponse
Non. Le contexte est temporaire : il sert à la requête en cours. Les poids ne sont pas modifiés pendant l'inférence.
Pourquoi séparer données d'entraînement, de validation et de test ?
Voir la réponse
Pour mesurer le comportement sur des cas tenus à l'écart. Si les mêmes exemples servent partout, le modèle peut sembler performant alors qu'il a seulement mémorisé.
Sources et pour aller plus loin
- Tokenizer d'OpenAI : visualiser le découpage d'un texte en tokens.
- Lost in the Middle : une étude sur la difficulté des modèles à exploiter l'information placée au milieu d'un long contexte (Liu et al., 2023).