Un LLM, ou grand modèle de langage, produit du texte en prédisant une suite de tokens. Cette définition paraît modeste face à ses résultats, mais elle donne un bon point de départ : le modèle construit une distribution de probabilités, choisit une suite, puis recommence.
Une prédiction répétée
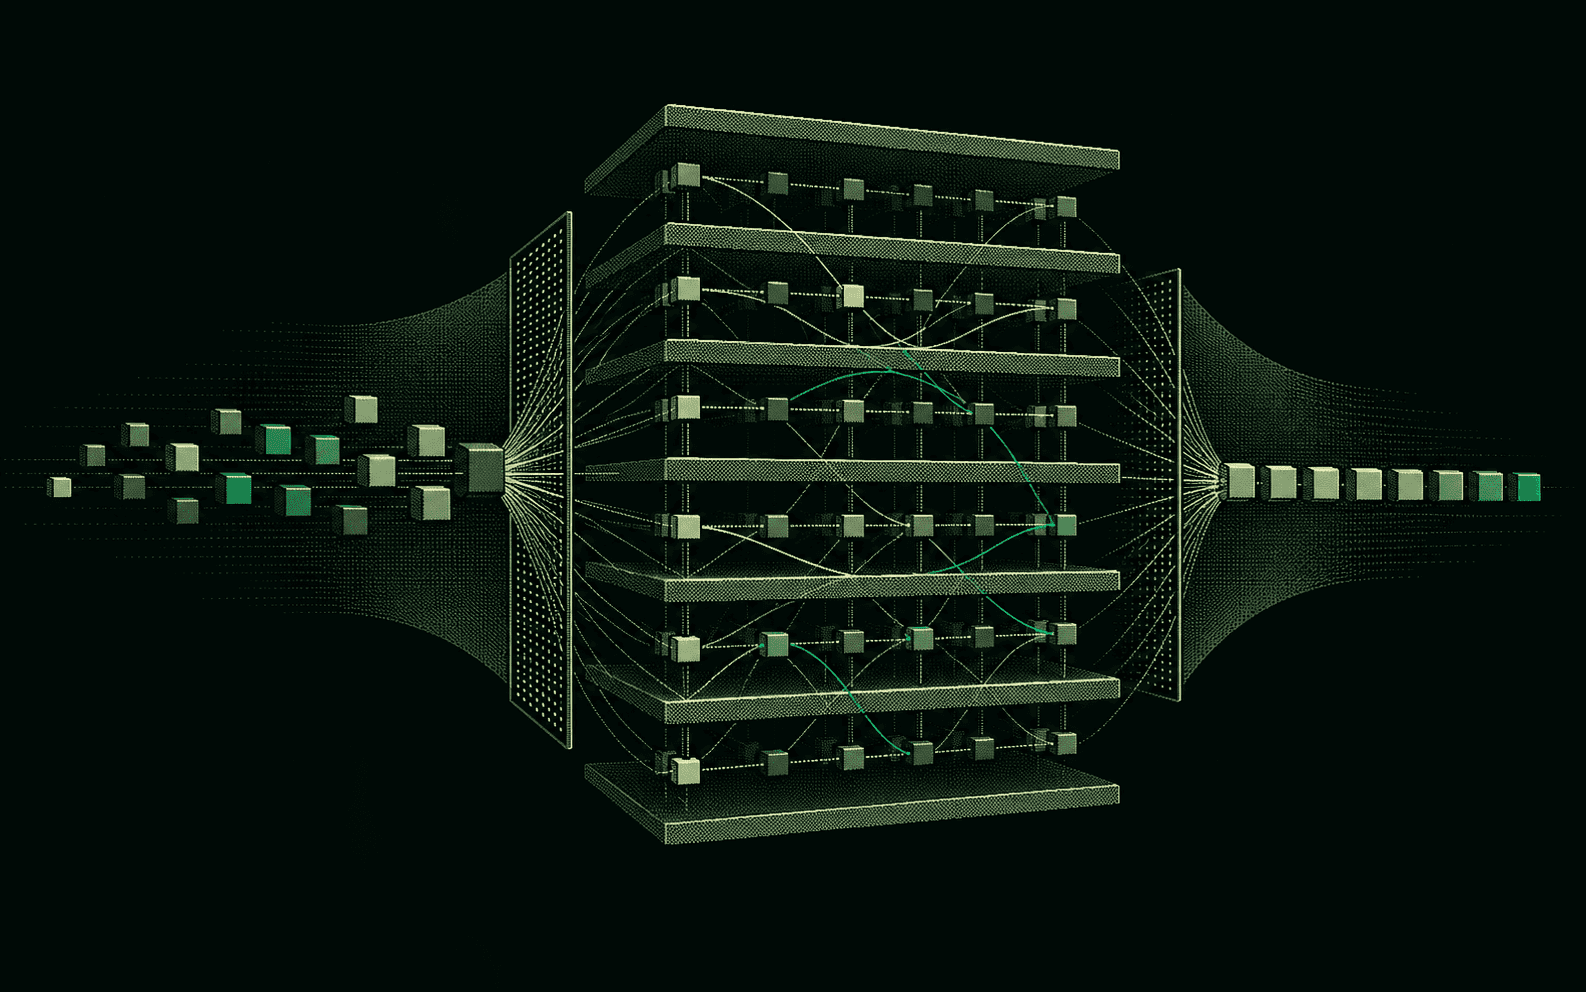
Après votre demande, le tokenizer crée une suite d'identifiants. Le modèle calcule quel token pourrait suivre. Un algorithme d'échantillonnage choisit l'un des candidats. Ce token rejoint le contexte et le cycle recommence jusqu'à la fin de la réponse.
Ce processus explique pourquoi le texte arrive progressivement. Il explique aussi pourquoi deux réponses peuvent différer malgré une demande identique : le choix n'est pas toujours déterministe.
Le rôle de l'attention
L'architecture Transformer a rendu possible l'entraînement de modèles de grande taille. Son mécanisme d'attention aide chaque position à pondérer les autres éléments du contexte.
Pour interpréter « La carte graphique ne tient pas dans le boîtier parce qu'elle est trop longue », le modèle doit relier « elle » à « carte graphique ». L'attention construit ce type de relation à plusieurs niveaux et avec plusieurs têtes spécialisées.
Paramètres et capacités
Un modèle 8B contient environ huit milliards de paramètres. Plus de paramètres peuvent augmenter la capacité d'apprentissage, mais la taille ne résume pas la qualité. Les données, la méthode d'entraînement, le tokenizer, la longueur de contexte et l'adaptation finale comptent aussi.
Modèle de base
Il poursuit du texte selon les régularités apprises.
- Comportement brut
- Utile pour la recherche et l'adaptation
- Instructions moins fiables
Modèle instruction
Il a été adapté pour suivre des demandes et dialoguer.
- Réponses plus structurées
- Garde-fous variables
- Toujours sujet aux erreurs
Ce que « comprendre » veut dire ici
Un LLM construit des représentations riches du langage et peut résoudre de nombreux problèmes. Cela ne prouve pas qu'il possède une compréhension humaine, une expérience ou une intention. Le mot « comprendre » doit donc être utilisé avec précision.
Le modèle peut produire une explication correcte, utiliser une règle, traduire un texte ou générer du code. Il peut aussi inventer une référence avec la même assurance. Ses capacités sont réelles, mais leur fiabilité dépend du problème et de la manière dont on vérifie la sortie.
Pourquoi la taille locale compte
Les poids doivent être chargés dans la RAM, la VRAM ou les deux. Un modèle plus grand exige davantage de mémoire et souvent plus de temps par token. La quantization réduit cette empreinte en représentant les poids avec moins de bits.
Le bon modèle pour le bon travail
Choisissez un modèle selon la langue, la tâche, la licence, la mémoire disponible et la vitesse nécessaire. Un petit modèle spécialisé peut dépasser un grand modèle généraliste sur un usage étroit. La prochaine étape consiste à comprendre comment la quantization modifie cet arbitrage.
L’essentiel
- Un LLM génère du texte en prédisant un token, en l'ajoutant au contexte, puis en recommençant.
- L'attention permet à chaque position de pondérer les autres éléments du contexte.
- Le nombre de paramètres ne résume pas la qualité : données, entraînement et adaptation comptent autant.
- Un modèle instruction a été adapté pour suivre des demandes ; il reste sujet aux erreurs.
- Un ton assuré n'est pas une preuve de vérité.
Testez-vous
Répondez de tête ou par écrit, puis vérifiez. Se tester juste après la lecture aide à retenir.
Pourquoi deux réponses à la même question peuvent-elles différer ?
Voir la réponse
Le modèle calcule des probabilités pour le token suivant et un algorithme d'échantillonnage en choisit un. Ce choix n'est pas toujours déterministe.
À quoi sert le mécanisme d'attention ?
Voir la réponse
Il permet à chaque position du texte de pondérer les autres éléments du contexte, par exemple pour relier un pronom au nom qu'il désigne.
Quelle différence entre un modèle de base et un modèle instruction ?
Voir la réponse
Le modèle de base poursuit du texte selon les régularités apprises. Le modèle instruction a été adapté pour suivre des demandes et dialoguer.
Sources et pour aller plus loin
- Attention Is All You Need : l'article qui a introduit l'architecture Transformer (Vaswani et al., 2017).
- The Illustrated Transformer : une explication visuelle de l'attention, pas à pas (en anglais).
- Cours LLM de Hugging Face : un cours gratuit et progressif sur les modèles de langage.